Транскрибація дзвінків українською: чому точність падає на суржику і що з цим робити
Що впливає на точність розпізнавання мовлення в телефонних записах: якість каналу, шум, перемикання мов посеред фрази, власні назви. Як перевірити сервіс транскрибації на своїх дзвінках, а не на демо.
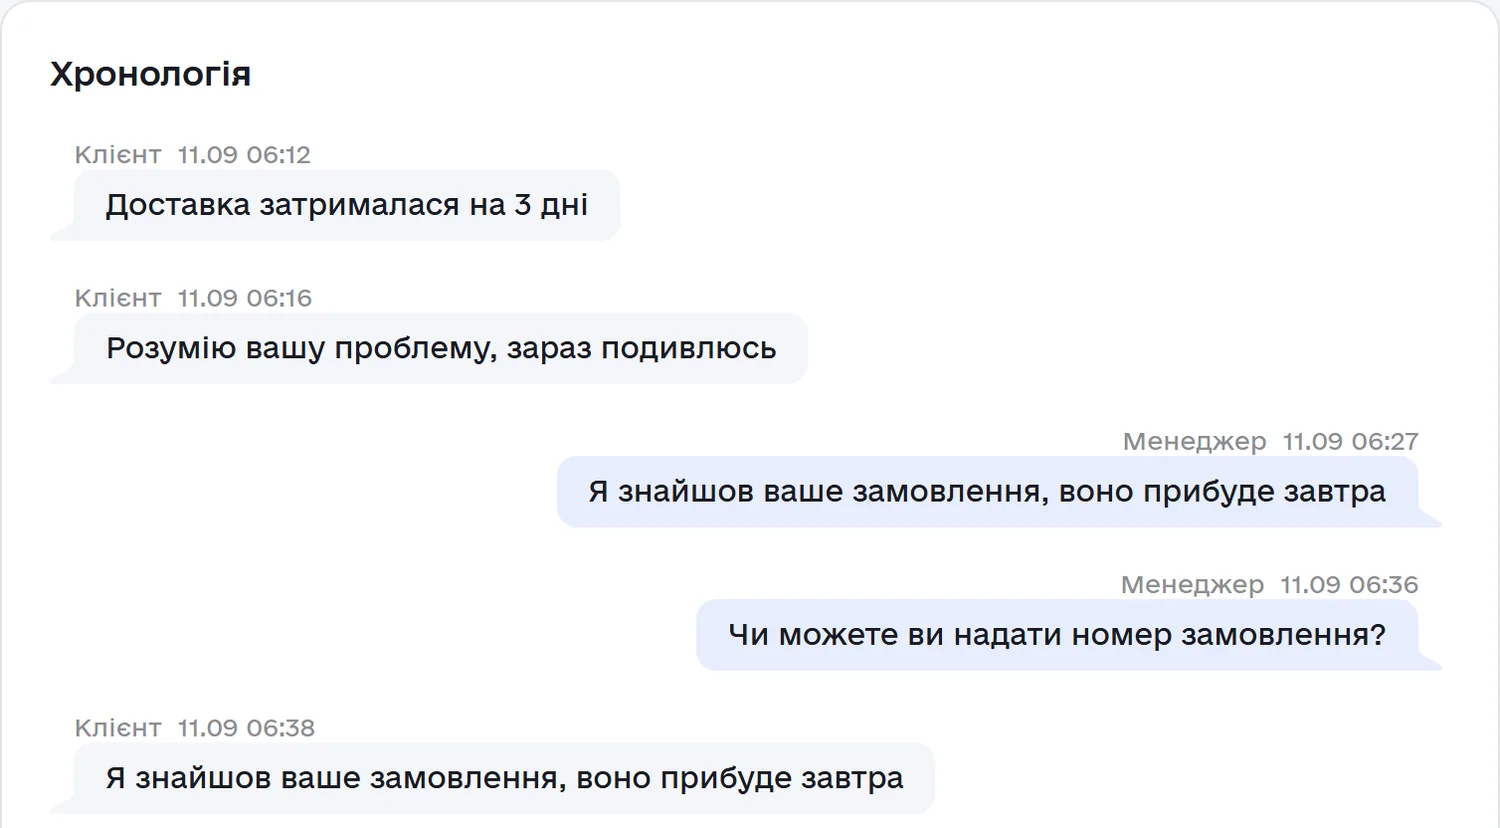
Кожен сервіс розпізнавання мовлення обіцяє «точність 95–98%». Потім ви завантажуєте запис реального дзвінка з відділу продажів — і бачите текст, де адреса перетворилась на набір складів, а половина реплік клієнта приписана менеджеру. Обидві цифри правдиві: просто одна виміряна на чистому студійному записі, а друга — на телефонній лінії, де клієнт говорить із маршрутки.
Розбираємось, від чого залежить точність транскрибації дзвінків українською, чому суржик — окрема проблема, і як перевірити сервіс так, щоб не розчаруватися після підписання договору.
Як міряють точність
Стандартна метрика — WER (word error rate), частка слів, які розпізнано неправильно, пропущено або додано зайвих. Точність 97% означає три помилки на сто слів. У п’ятихвилинній розмові це близько 600 слів і приблизно 18 помилок. Якщо ці помилки припадають на «так», «ну», «угу» — текст читається нормально. Якщо на артикул товару, суму і дату доставки — транскрипт стає непридатним, хоча цифра та сама.
Тому дивитися треба не лише на загальний відсоток, а на те, де саме модель помиляється: у числах, назвах, іменах чи в службових словах.
Шість причин, чому точність падає на реальних дзвінках
1. Телефонний канал
Студійний запис — 44 кГц, телефонний — 8 кГц, до того ж стиснений кодеком. Частина звуків просто не потрапляє в запис: «с» і «ф», «п» і «т» у телефонному каналі майже нерозрізненні. Модель, навчена на подкастах і аудіокнигах, на такому звуці втрачає 5–10 пунктів точності одразу.
2. Шум і перебивання
Вулиця, офіс із десятьма менеджерами, гучний зв’язок у машині. Плюс люди в розмові перебивають одне одного, а на моно-записі дві накладені репліки — це каша, яку не розбере жодна модель.
3. Суржик і перемикання мов посеред фрази
Це головна українська специфіка. Менеджер починає українською, клієнт відповідає російською, далі обидва говорять сумішшю: «Ну я вам перезвоню, коли буде готово, окей?» Моделі, які працюють з однією мовою на файл, роблять одну з двох речей: або «перекладають» усе на літературну мову — і тоді з тексту зникає те, що клієнт казав насправді, — або розсипаються на транслітерацію. Правильна поведінка — записати так, як сказано, і не втратити зміст.
4. Власні назви, артикули, адреси
«Вул. Івана Мазепи, 14-Б», «модель ХК-2200», прізвище «Пшеничний» — усе, чого модель не бачила в навчальних даних, вона замінює на схоже за звучанням. Саме тут концентруються помилки, які роблять транскрипт непридатним для CRM.
5. Темп і діалект
Швидка мова, ковтання закінчень, регіональна вимова. Це впливає менше, ніж канал і шум, але додає помилок у довгих реченнях.
6. Розділення спікерів
Якщо телефонія пише обидві сторони в один канал, системі доводиться вгадувати, хто говорить, за тембром. На коротких репліках («так», «добре») вона помиляється часто. Результат — чек-лист оцінює менеджера за словами клієнта.
Що з цим робити
- Пишіть стерео. Більшість сучасних АТС і телефоній уміють записувати кожну сторону в окремий канал. Це одна галочка в налаштуваннях, яка знімає проблему розділення спікерів повністю.
- Дайте моделі словник. Назви ваших продуктів, артикули, імена менеджерів, типові адреси. Сервіси, які підтримують користувацький словник, розпізнають «ХК-2200» замість «ха-ка дві тисячі».
- Обирайте модель, яка бачила змішану мову. Запитайте прямо, як сервіс поводиться з перемиканням мов посеред фрази, і перевірте на своєму записі.
- Нормалізуйте після розпізнавання. Числа, дати, суми й телефони треба приводити до одного вигляду вже після транскрибації, інакше пошук по розмовах не знайде «14 лютого», записане як «чотирнадцяте».
- Перевіряйте вибірку людиною. Раз на місяць — десять розмов вручну. Не для того, щоб виправляти, а щоб побачити, де саме модель просідає на ваших даних.
Як перевірити сервіс на своїх дзвінках
Не оцінюйте сервіс за демо-записом: він підібраний так, щоб усе працювало. Методика на два-три години:
- Зберіть 20 записів — різні менеджери, вхідні й вихідні, тихі й гучні, коротка і довга розмова, обов’язково кілька із суржиком і переходами між мовами.
- Для п’яти з них зробіть еталон — прослухайте і запишіть текст вручну. Це нудно, але без еталона у вас не буде цифри, лише враження.
- Порахуйте помилки на цих п’яти: окремо у звичайних словах, окремо в числах, назвах і іменах.
- Перевірте, чи модель не «згладжує» суржик. Якщо клієнт сказав «шо по цінє», а в транскрипті «що по ціні» — зміст збережено, і це прийнятно. Якщо цілу репліку переписано іншими словами — ні.
- Подивіться на розділення спікерів і таймкоди. Клікніть на репліку — чи перемотує запис саме на неї.
- Перевірте решту 15 побіжно: чи є розмови, на яких результат очевидно гірший, і чому.
Після такої перевірки ви знаєте свою реальну точність, а не рекламну.
Транскрипт — не мета, а сировина
Сам по собі текст розмови мало кому потрібен: його ніхто не читатиме на 200 дзвінків у день. Цінність з’являється, коли з транскрипта автоматично витягуються резюме, оцінка за чек-листом, домовленості й теми, які повторюються з дзвінка в дзвінок. Про це — у статтях про контроль якості на всьому обсязі дзвінків і про чек-лист оцінки.
В Omniscore точність вимірюється саме так, як описано вище: на пілоті ми беремо ваші записи, порівнюємо з еталоном і називаємо цифру до підписання договору. На чистому записі українською вона близька до 97%, на реальних дзвінках із шумом і суржиком — нижча, і ми називаємо її чесно. Залишити заявку на пілот.